Métodos neuronales para la extracción de terminología de ciberseguridad
The REUSE Company y Tecnalia Research & Innovation (centro tecnológico subcontratado por The Reuse Company en este proyecto) están colaborando en la aplicación de técnicas de procesamiento de lenguaje natural para la generación de una ontología relevante en el ámbito de la ciberseguridad.
Las ontologías son métodos de representación de conocimiento usadas en un amplio abanico de tareas en el procesado de lenguaje natural. Un uso particular de las ontologías es la extracción de reglas en el ámbito de la ciberseguridad. Estas reglas pueden ser usadas posteriormente con múltiples propósitos, por ejemplo, comprobar que ciertas características de los sistemas software se ciñen a los requisitos de una o más normas de ciberseguridad.
Una de las primeras fases para la construcción de una ontología es la recolección de la totalidad del vocabulario que formará parte de ella. El vocabulario es el conjunto de tipos, es decir, palabras sin repetición, en un corpus lingüístico. Los corpus utilizados para esta tarea son normas de ciberseguridad con amplio uso en la industria.
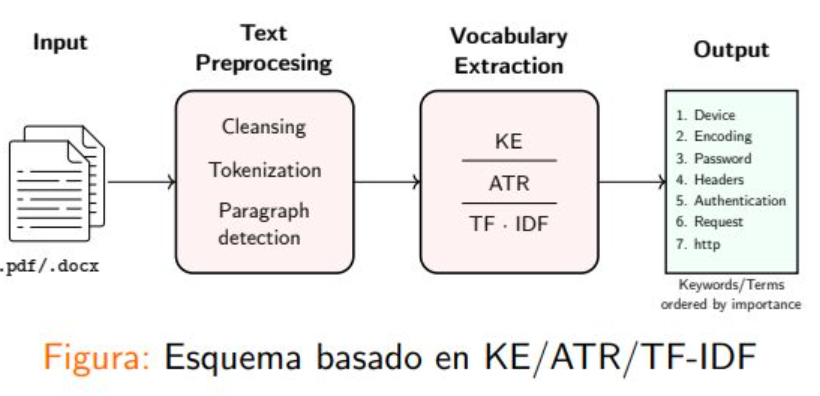
Los métodos neuronales que se están desarrollando responden a tres tareas diferentes del procesado de lenguaje natural.
- Keyword Extraction (KE): es la tarea de extraer las palabras clave en un texto, es decir, aquellas «palabras contenido» que mejor describen el contenido de, en este caso, una norma de ciberseguridad. Tradicionalmente son métodos estadísticos aplicados al lenguaje.
- Automatic Term Retrieval (ATR): es la tarea de extraer las palabras de un dominio específico en un texto. A diferencia de KE, esta búsqueda está dirigida al contexto de la ciberseguridad. Los métodos neuronales supervisados como KeyBERT consiguen buenos resultados.
- Text Classification (TC): es la tarea de clasificar texto en una o más clases. El modelado para la extracción de vocabulario parte de una clasificación de oraciones para extraer los requisitos de ciberseguridad del texto plano. Este método utiliza información semántica (modelos de semántica distribucional pre-entrenados (BERT)), morfo-sintáctica (a partir de representación extraída de árboles de constituyencia) y de dependencias (entre palabras), con el objetivo de minimizar el ruido introducido en oraciones largas.
Los resultados de esta investigación realizada por Tecnalia, que podemos denominar de manera resumida como “extracción de vocabulario aplicando técnicas no deterministas”, se combinarán con las técnicas deterministas que ya venía aplicando The Reuse Company en su negocio, buscando, como se indicaba al principio de la noticia, mejorar el rendimiento de las actividades de detección de requisitos de ciberseguridad realizadas por los ingenieros de sistemas.
Autor: Pedro González Bascoy (Tecnalia)
hashtag#ia hashtag#cibersecurity hashtag#innovation hashtag#investigación hashtag#research